21/9/2026
Black Friday e picos de tráfego: como avaliar e mitigar riscos no e-commerce


Grace Libanio
Partner e CRO

10/11/2026
Para CIOs, CTOs e líderes de engenharia, a proximidade de grandes datas do varejo — como a Black Friday e lançamentos de alto impacto — funciona como o teste definitivo da governança de TI. Esses eventos não avaliam apenas a tração comercial da empresa; eles colocam à prova a resiliência da infraestrutura, a solidez da arquitetura de software e o preparo estratégico de toda a operação digital.
Mas como mitigar riscos tecnológicos antes da Black Friday? A resposta exige mapear dependências críticas, estabelecer limites claros de operação, validar o comportamento dos sistemas sob picos de tráfego e preparar planos de contingência robustos.
Em cenários de alta concorrência e margens apertadas, a estabilidade sistêmica deixa de ser apenas uma métrica técnica operacional. A disponibilidade e a performance passam a ser os pilares centrais da proteção de receita e da preservação da reputação da marca.
O desafio da liderança é claro: garantir que o ecossistema tecnológico suporte picos massivos de acesso sem comprometer o orçamento de nuvem com super provisionamento desnecessário, equilibrando custo, risco e tempo de resposta ao mercado.
A expectativa para a Black Friday ilustra a magnitude do desafio: projeta-se que o comércio eletrônico movimente cerca de R$ 13,3 bilhões. Com a forte pressão sobre as requisições de servidores, a previsibilidade da operação é a melhor barreira eficaz contra instabilidades severas e perdas operacionais.
Este artigo detalha o raciocínio arquitetural e as etapas práticas para mapear e mitigar riscos tecnológicos de forma preventiva, protegendo o faturamento e a experiência do cliente quando o volume de tráfego atinge o seu limite crítico.
A indisponibilidade de um e-commerce durante uma campanha de tráfego intenso gera consequências imediatas. A perda de faturamento ocorre em tempo real, e a recuperação desse prejuízo financeiro é improvável no curto e médio prazo, uma vez que o momento de intenção de compra do consumidor é efêmero.
Historicamente, incidentes de instabilidade já resultaram em perdas expressivas no varejo digital. Contudo, esses números refletem apenas a receita direta não capturada no momento da falha sistêmica. O impacto em cascata é muito mais profundo. Quando o consumidor se depara com uma página de carregamento lento ou uma transação que falha, a tendência natural é que ele busque a concorrência imediata.
O reflexo desse atrito é a elevação do Custo de Aquisição de Clientes (CAC) que o time de marketing investiu para atrair aquele tráfego.
Além do prejuízo financeiro tangível, a instabilidade compromete o alinhamento entre as áreas de Tecnologia e Negócios. Quando a plataforma falha no momento de maior expectativa do ano, a equipe de engenharia pode ser percebida como um gargalo operacional, o que desgasta a relação de confiança com o C-level.
Uma análise recente no e-commerce brasileiro revelou um panorama preocupante: de 35 das principais lojas virtuais avaliadas, 18 enfrentaram falhas técnicas significativas ou rupturas de processos na jornada de compra durante a Black Friday. Isso significa que mais da metade das grandes operações de varejo falhou em proteger suas jornadas críticas no momento de maior exigência de performance.
Estudos sobre o comportamento do e-commerce em grandes datas promocionais indicam que falhas técnicas significativas e interrupções na jornada de compra afetam uma parcela relevante das grandes lojas virtuais no país. Em vez de depender de estimativas globais genéricas de custo de inatividade, o cálculo real do impacto deve considerar a receita horária da operação nos momentos de pico combinada ao custo de marketing desperdiçado. A cada minuto de inatividade, o prejuízo se acumula.
Para adotar uma postura proativa, a engenharia de software precisa mapear detalhadamente onde as falhas costumam se originar. A instabilidade de um portal de vendas raramente é fruto de um erro isolado; trata-se, na maioria das vezes, de uma reação em cadeia deflagrada por gargalos na troca de dados.
Muitas organizações confiam excessivamente na escalabilidade da infraestrutura em nuvem, acreditando que o provisionamento de recursos resolverá qualquer sobrecarga. Contudo, a verdadeira complexidade de um e-commerce moderno reside nas integrações assíncronas e na latência de serviços terceirizados. Abaixo, analisamos os vetores de risco que exigem priorização no roadmap de qualidade.
A arquitetura de uma plataforma de vendas digitais depende de um ecossistema complexo de APIs, microsserviços e sistemas integrados. Durante saltos abruptos de tráfego, as conexões com parceiros externos representam o ponto mais sensível da infraestrutura. O front-end pode estar otimizado, operando em rede de distribuição de conteúdo (CDN) com alto cache, mas se as integrações de retaguarda falharem, a venda não se concretiza.
A resiliência de uma arquitetura distribuída é limitada pelo seu nó de menor capacidade. Mapear os limites operacionais e a concorrência de cada integração terceirizada é um passo essencial de governança.
Ao contrário de uma queda total do sistema, a degradação gradual de performance atua de forma silenciosa, corroendo a taxa de conversão a cada segundo adicional de carregamento. O cliente experimenta essa fricção quando o carrinho de compras demora para responder ou quando as consultas de endereço apresentam atrasos.
Sob a perspectiva moderna de engenharia, o monitoramento de disponibilidade simples é insuficiente. A liderança precisa garantir a observabilidade de métricas de experiência real do usuário, como o Largest Contentful Paint (LCP) e o Interaction to Next Paint (INP), além de analisar a latência nos percentis p95/p99 e a taxa de sucesso das jornadas críticas.
Do ponto de vista arquitetural, essa latência decorre frequentemente de transações em banco de dados sem indexação correta, consultas ineficientes ou bloqueio de renderização do front-end por scripts de terceiros (como pixels de rastreamento).
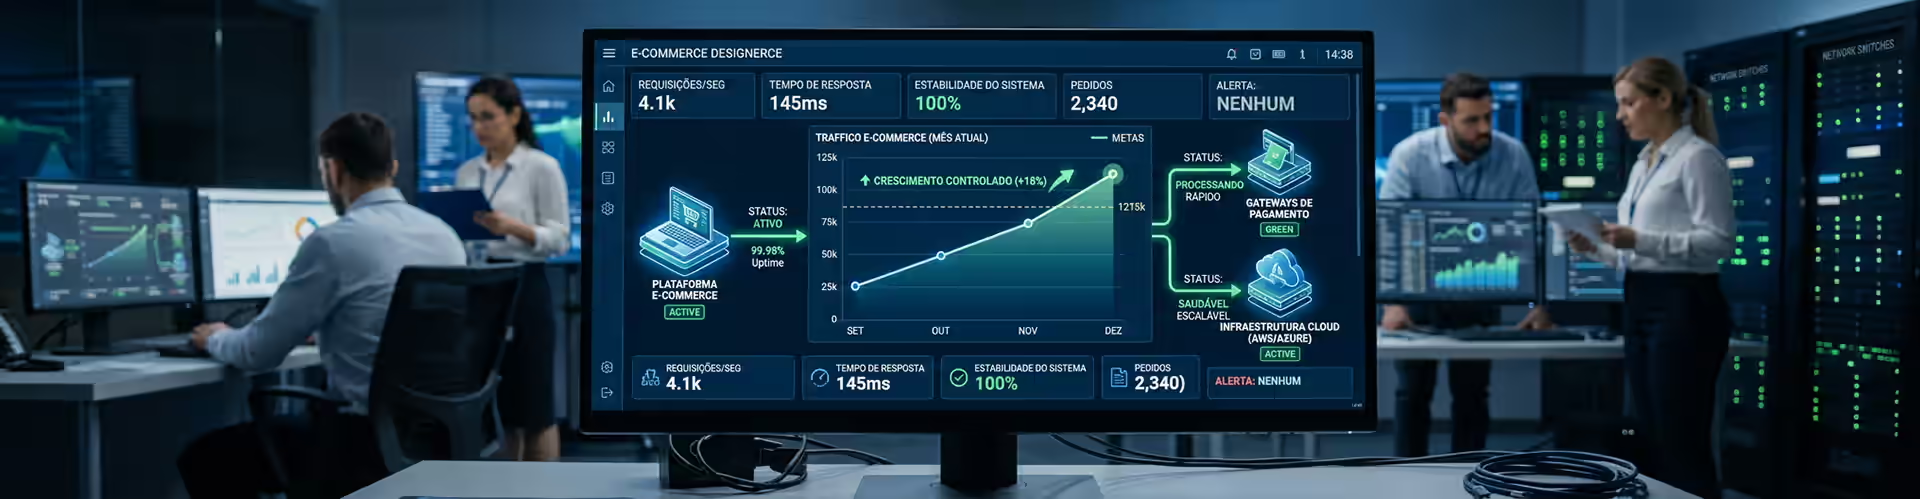
Mitigar falhas exige método e governança. O início tardio de validações profundas impede correções de arquitetura complexas. Embora o prazo de planejamento ideal varie de acordo com a arquitetura de cada empresa, a complexidade dos sistemas e o tempo de correção necessário, adotar uma janela de 60 a 90 dias antes do evento fornece uma margem segura para realizar melhorias estruturais profundas.
Para estruturar essa preparação, a liderança técnica pode mapear riscos específicos e seus indicadores operacionais em uma matriz de validação. Veja um exemplo:
Os testes de performance constituem a base científica para dimensionar a capacidade real da infraestrutura:
O QA Preventivo atua de forma abrangente nas jornadas críticas do consumidor — desde a autenticação e busca até a aplicação de cupons e a finalização de pagamentos. Seu escopo vai além da interface de usuário e usabilidade, englobando a validação de contratos de API, concorrência, idempotência das transações, resiliência das integrações e integridade de dados diante de falhas.
A atuação de engenharia de qualidade garante que as regras de negócio funcionem perfeitamente em múltiplos dispositivos, prevenindo erros como requisições duplicadas ou falhas de comunicação assíncrona.
A resposta a incidentes de infraestrutura precisa ser planejada estrategicamente para garantir a continuidade dos serviços digitais.
Veja como o Grupo Casas Bahia prepara uma operação digital de alta exposição para a Black Friday, dando mais confiança executiva sobre capacidade, estabilidade e experiência em um dos momentos mais críticos do varejo.
Antes de liberar a operação para um pico de tráfego, a liderança técnica deve responder a cinco perguntas fundamentais:
Gerenciar picos extremos de acessos com base em respostas improvisadas coloca em risco a receita e o posicionamento da organização. Para as lideranças focadas em previsibilidade, a mitigação preventiva e o QA integrado desde as fases iniciais do ciclo de desenvolvimento (Shift-Left) garantem que a receita flua de forma segura e consistente pela plataforma.
Se a sua equipe precisa mapear os limites operacionais e de infraestrutura de forma precisa antes do próximo grande evento, conheça as soluções da Sofist. Como parceira estratégica de engenharia de qualidade de software, apoiamos o seu time no diagnóstico de riscos de performance e na validação técnica de jornadas críticas, garantindo tranquilidade operacional para sua empresa.
1. Qual é o momento ideal para iniciar os testes de estresse para a Black Friday?
Embora a janela ideal varie dependendo do tamanho da aplicação, recomenda-se planejar os testes de carga e estresse com uma margem de 60 a 90 dias. Esse prazo oferece tempo suficiente para que a equipe de engenharia identifique limites operacionais, otimize consultas de banco de dados e faça correções estruturais antes do congelamento do código (code freeze).
2. O que é latência silenciosa e como monitorá-la de forma eficiente?
É a perda gradual de performance que não chega a derrubar o sistema, mas causa atrasos na jornada do usuário. Para monitorá-la, a engenharia deve analisar métricas de experiência real (Core Web Vitals como LCP e INP), o tempo de resposta das transações no percentil p95/p99 e a taxa de sucesso das chamadas de API, evitando depender apenas de monitoramentos de status simples (uptime).
3. Como o QA Preventivo se diferencia dos testes de usabilidade tradicionais?
Enquanto os testes tradicionais focam no comportamento da interface, o QA Preventivo aprofunda-se em aspectos técnicos da aplicação. Ele engloba a validação de contratos de API, concorrência de requisições, idempotência transacional e simulação de falhas integradas, garantindo que o sistema processe transações com segurança mesmo sob estresse severo.
4. Por que a falha de uma API externa pode comprometer toda a plataforma?
APIs de parceiros (como frete ou pagamentos) possuem limites de requisição por segundo (rate limits). Ao atingirem esse teto, respondem com erros HTTP 429 ou extrema lentidão. Se a arquitetura do e-commerce não tiver mecanismos de contingência isolados, essa lentidão pode travar threads de processamento no servidor local, gerando um travamento em cascata.
5. Qual a diferença entre mitigação de riscos operacionais e Disaster Recovery?
A mitigação de riscos operacionais e os planos de contingência (como Circuit Breaker e degradação controlada) tratam de manter o sistema funcionando de forma resiliente durante o tráfego normal e de pico. O Disaster Recovery é uma governança mais ampla de TI voltada à recuperação de dados e infraestrutura após falhas críticas catastróficas, definida por métricas rígidas de RTO (Recovery Time Objective) e RPO (Recovery Point Objective).
Tem dúvidas sobre esse conteúdo?
Grace Libanio
Partner e CRO
Grace Libânio, CRO e Partner na Sofist, é uma líder com vasta experiência em Business Development, Complex Sales e B2B Sales. Sua jornada de 13 anos na Sofist é um case de sucesso: de estagiária, ela evoluiu para Head de Vendas e de Negócios, e hoje é responsável pela estratégia de crescimento e receita da companhia.